上一篇讲了 AI 管线,把采集、归纳、产出串成一条线。收得快,问题也跟着露出来:库存里躺着几万篇旧笔记,绝大多数存进来以后,再没被打开过。这篇换种节奏,聊点慢的事,怎么把一篇存了很久的笔记真正读透。
我的库现在三万多篇笔记。近半年真正被打开、被引用、被改写过的,不到两成。其余八成,存进来那天就是巅峰,之后没人再碰。
这不算收藏的失败。收集解决「有」,读透才解决「用」。整理方法大多在管「有」,深读管的是「用」。
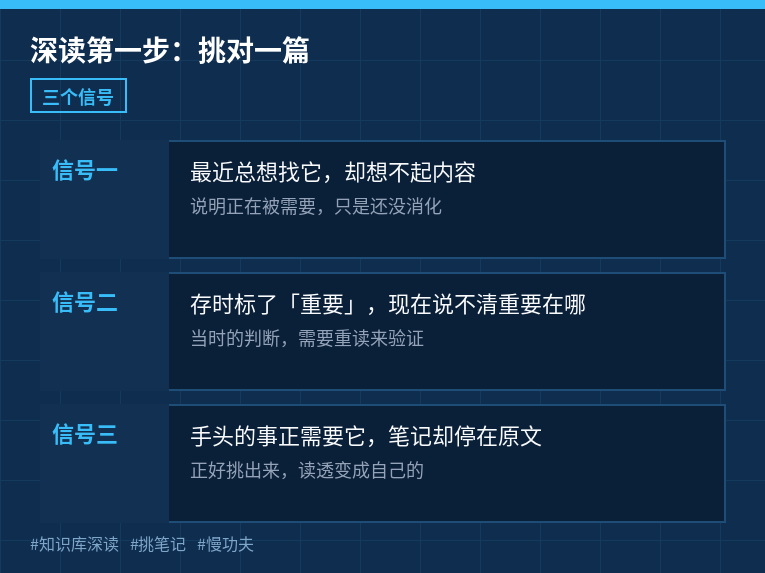
挑哪篇:三个信号
最近总想找它,但想不起内容。说明正在被需要,只是没消化。
存的时候标了「重要」,现在说不清重要在哪。标记是当时的判断,读透才知道判断成不成立。
手头的事跟它相关,笔记却停在原文状态。比如正在写一个主题,库里躺着几篇相关收藏,挑一篇深读正合适。
信号有了,做法很朴素:一周挑一篇,给完整的三十分钟。
读透三步
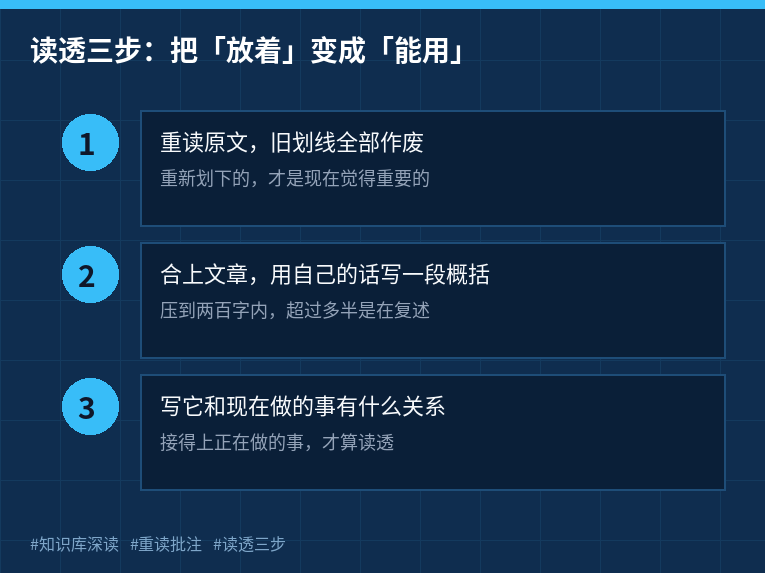
第一步,重读原文,把存的时候划的线全部作废。旧划线是当时自己的判断,不一定对。重新划下来的,才是现在觉得重要的。
第二步,合上文章,用自己的话写一段「它到底说了什么」。写不出来,说明没读懂,回去再读。写得出来,压到两百字以内。超过这个数,多半在复述,不是概括。
第三步,写一段「它跟我现在做的事有什么关系」。这步最关键。读一篇笔记,接不上正在做的事,读完也是白读。接得上,笔记才真正变成自己的。
读透之后:写回原笔记
读透的产物直接写回原笔记,不另开一篇。我在笔记开头放一个「重读批注」区,记三行:日期、一句话概括、现在能用在哪。下次翻到,先看批注,几秒钟就知道值不值得再花时间。
批注写完,顺手删掉没用的部分,补上相关笔记的链接。删比存更需要判断,读透之后自然知道哪些是冗余。链接一补,这篇重新接回知识网络。
节奏:一周一篇就够
深读是低频动作。一周一篇,一年五十篇。对比三万的库存,少得可怜。但这一篇篇是真正在「用」笔记,比一次批量整理一百篇有价值。批量整理是横向的,把文件挪来挪去;深读是纵向的,往一篇笔记里挖。
三个坑
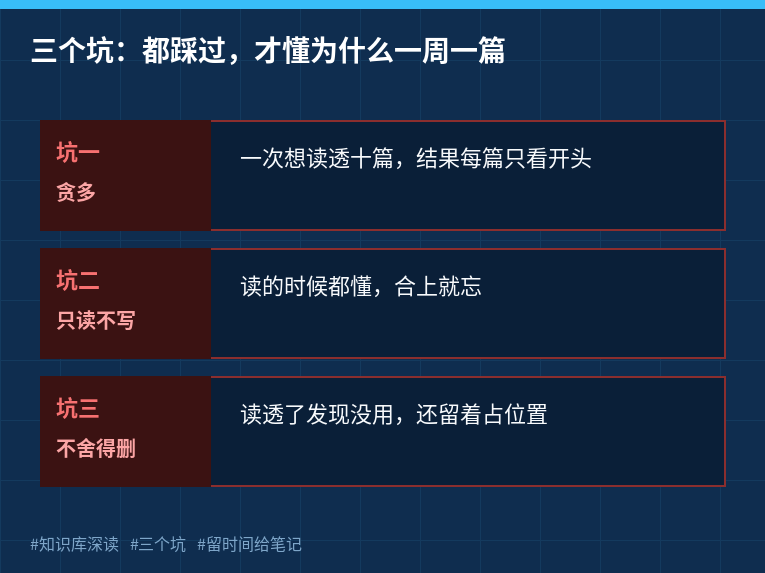
贪多。一次想读透十篇,结果每篇只看了开头。一周一篇,读透再换。
只读不写。读的时候都懂,合上就忘。深读必须留文字痕迹,那三行批注就是痕迹。
不舍得删。读透了发现没用,纠结半天还是留着。留着就继续占位置、干扰检索。判断没用了,删掉也是收获。
收尾
前几篇聊的都是让知识库变快的方法。这篇反着来,留时间把一篇笔记读透。快有快的用处,慢也有慢的用处。收集、归纳、产出,最后都落在「读」上。AI 归纳得再好,一篇笔记真正被理解,还是得自己过一遍。
系列聊了不少提速的办法。下篇想聊聊,库变快之后,怎么让它保持自己的味道,而不是被工具牵着走。